A empresa de tecnologia divulgou os recentes avanços em seu programa Azure Maia em janeiro deste ano, juntamente com seu chip Maia 200.
Por Redação, com Europa Press – de São Francisco
A Microsoft apresentou o Maia 300, seu novo chip de inteligência artificial (IA) de terceira geração, com lançamento previsto para 2027, projetado para otimizar a inferência e atender às novas tarefas mais exigentes de IA, bem como para expandir sua própria infraestrutura de IA, com um desempenho sete vezes maior na escala de rack do que seu antecessor, o Maia 200.
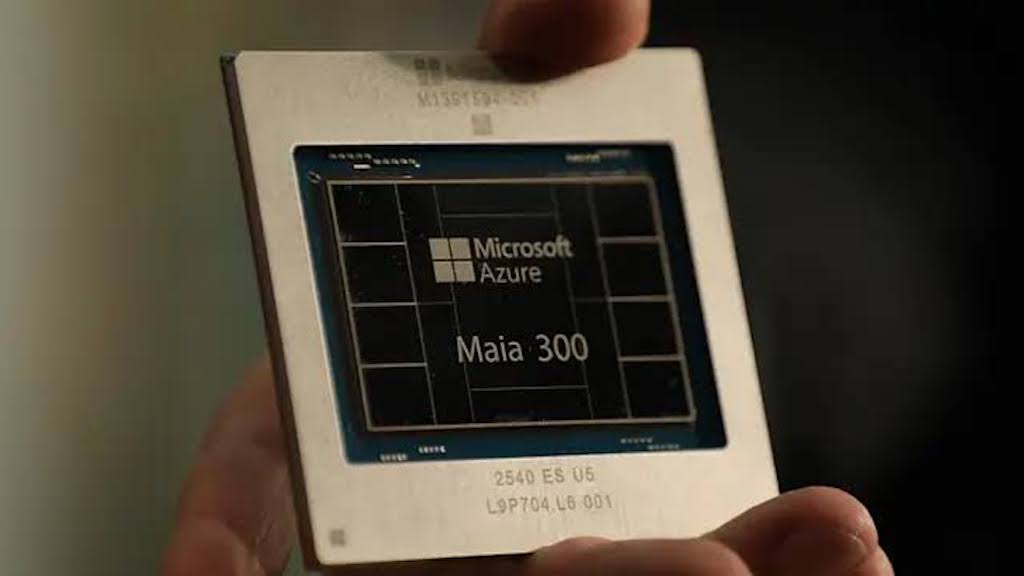
A empresa de tecnologia divulgou os recentes avanços em seu programa Azure Maia em janeiro deste ano, juntamente com seu chip Maia 200. Agora, ela transferiu seus planos de expandir a família Maia para implantações de “vários gigawatts” a partir de 2027, com o objetivo de transformar esse ecossistema no “principal sistema de inferência para produtos e serviços da Microsoft”.
Com isso, prevê-se que a gigante da tecnologia reduza sua dependência de outras empresas de chips de IA, como a Nvidia ou a AMD, apostando em seus próprios sistemas internamente.
Nesse sentido, a empresa esclareceu que o chip Maia 200 já está em produção e é utilizado atualmente em cargas de trabalho de produção da Microsoft, incluindo o Microsoft Copilot, bem como no desenvolvimento de modelos de próxima geração, como o GitHub Copilot e o Microsoft Foundry.
Na prática, conforme esclareceu a Microsoft em um comunicado em seu blog, o Maia 200 já é capaz de executar modelos da OpenAI, os próprios modelos MAI da Microsoft e as principais famílias de modelos de código aberto.
Maia 300
No entanto, a Microsoft pretende ir além e, seguindo essa linha, além de atualizar os avanços do Maia 200, apresentou seu processador de IA de terceira geração, o Maia 300.
Trata-se de um sistema inteligente projetado com uma arquitetura baseada em inferência e otimizada para “os novos tipos de cargas de trabalho de IA” que surgem atualmente, como o raciocínio de contexto longo, experiências conversacionais sensíveis à latência ou tarefas agentais sustentadas de várias etapas.
Segundo a empresa de tecnologia, esse modelo se destaca por melhorar a eficiência em todo o sistema, já que se espera que ofereça 40% a mais de tokens por megawatt em comparação com os principais sistemas baseados em GPU. Além disso, em comparação com o Maia 200, prevê-se que ele alcance um desempenho de tokens até sete vezes maior em escala de rack, graças à sua configuração completa de 96 aceleradores.
Entre suas capacidades, a Microsoft destacou como a arquitetura de fluxos de dados é aprimorada por ser definida por software e pela otimização do núcleo assistida por IA, de modo a maximizar a localidade, reduzir o movimento de dados e melhorar sua utilização em recursos de computação, memória e rede. Isso se traduz em uma melhoria no desempenho por vatio em comparação com as arquiteturas tradicionais de GPU.
Além disso, oferece uma largura de banda HBM por vatio “líder no setor”. Isso se deve ao fato de contar com oito pilhas HBM4 que proporcionam uma velocidade de transferência de dados de até 18 TB/s de largura de banda de pico de memória dentro de um TDP (potência térmica de projeto) de 950 watts. Assim, permite executar com eficiência modelos de grande porte e cargas de trabalho de longo contexto.
Quanto à sua arquitetura, ela é construída com base no nó de processo N2P da TSMC para maximizar seu desempenho por watt e é multichiplet, separando as funções de computação, controlador de memória e E/S para melhorar a eficiência, a escalabilidade e a estrutura de custos.
A Microsoft também garantiu que o Maia 300 oferece janelas de contexto maiores, com maior desempenho e uma melhoria na eficiência do modelo “dentro do mesmo limite de energia”.
Além disso, detalhou que também alcança maior desempenho de IA em cada rack, ao reunir 96 aceleradores dentro de um limite de potência de 167 quilowatts, para fornecer 27,6 TB de capacidade HBM e 1,7 PB/s de largura de banda HBM agregada em um domínio de expansão de alta velocidade.
Com tudo isso, o Maia 200 já começou a ser implantado nos Estados Unidos, na Europa e na Austrália. Já o Maia 300 chegará no próximo ano de 2027.
Meta
A Meta Superintelligence Labs lançou dois novos modelos de ponta, batizados de Muse Wonder e Muse Wonder Full, respectivamente, que são os primeiros da empresa a se equiparar em desempenho aos da Anthropic ou da OpenAI, com foco nas esferas profissional e pessoal.
O Muse Wonder já está disponível por meio da Meta Model API e do Muse Code, enquanto o Muse Wonder Full será disponibilizado aos assinantes do Muse Code, conforme detalhado em um anúncio que apresenta a nova família de modelos, Muse Wonder, distinta do Muse Spark.
A empresa de tecnologia destacou que o Muse Wonder traz consigo os recursos “Active Memory” e “Active Focus” para “manter um registro do que é importante e trabalhar diligentemente para alcançar o que se deseja”. Além disso, o Muse Wonder servirá de base para futuros modelos especializados que estarão disponíveis para os usuários no aplicativo Muse.
“O lançamento de hoje se baseia no trabalho de pré-treinamento e aprendizado por reforço e oferece nossos modelos mais avançados até o momento. Treinados em nosso data center Prometheus, com capacidade na escala de gigawatts, o Muse Wonder e o Muse Wonder Full reúnem os esforços de toda a Meta para oferecer recursos de ponta para tarefas complexas no âmbito profissional e no dia a dia das pessoas”, afirmou o laboratório de IA.
No que diz respeito às duas principais características do Muse Wonder, o “Active Memory” permite que o modelo se lembre e mantenha o contexto ao longo de várias conversas, enquanto o “Active Focus” se concentra na capacidade de trabalhar de forma autônoma em tarefas complexas de longo prazo. Ele também poderá gerar artefatos, ou seja, conteúdos estruturados e funcionais, como aplicativos web.
Além disso, a empresa de tecnologia destacou o desempenho de seus dois modelos em tarefas complexas e prolongadas de engenharia de software (SWE-Marathon e DeepSWE 1.1), ao mesmo tempo em que demonstram grande capacidade em áreas do direito (Harvey LAB-AA) e finanças (Vals Finance Agent V2), além de serem capazes de resolver tarefas desconhecidas fora do treinamento (out-of-distribution).
No entanto, de acordo com os testes da empresa, o Claude Opus 5.5 continua à frente no índice Artificial Analysis e em outros testes de programação, como o Terminal-Bench e o ProgramBench, enquanto o GPT-6 Astra lidera no trabalho profissional e continua à frente do Muse Wonder em programação por terminal (Terminal-Bench 4.0) e na área da saúde (HealthBench Pro).
Quanto ao preço, disponível por meio da Meta Model API, o Muse Wonder custará 4 dólares por milhão de “tokens” de entrada e 20 dólares por milhão de “tokens” de saída, o que o posiciona no mesmo nível, em termos de custo, que o GPT-5.6 Sol ou o Claude Opus 5.5.
Por outro lado, a Meta se certificou de incluir as proteções de segurança necessárias para evitar, na medida do possível, o desalinhamento entre os dois modelos. Nesse sentido, a empresa de tecnologia se refere ao Muse Wonder como seu “modelo mais alinhado até o momento” e ressalta que o alinhamento é o eixo central de sua compreensão sobre a criação de uma IA dedicada ao âmbito pessoal.
No entanto, não forneceu mais detalhes sobre as salvaguardas que introduziu, embora tenha anunciado que um relatório completo com as avaliações adicionais de segurança estará disponível em breve.